
- AI
- Edge Computing
- Industries
- Clea
L’Edge AI bien faite : comment nous avons construit un système LLM+RAG prêt pour la production sur un module SMARC
Nous avons mis en œuvre Llama 3.2 3B avec un pipeline RAG (Retrieval-Augmented Generation) complet sur du matériel Edge Qualcomm® Dragonwing™ QCS6490, ce qui prouve que des applications d’IA sophistiquées peuvent fonctionner de façon fiable en environnement de production, sans dépendance au cloud. Voici la réalité d’ingénierie qui permet d’y parvenir.
Le véritable défi d’ingénierie
L’engouement autour de l’« IA en périphérie » grandit depuis des années, mais la plupart des mises en œuvre déçoivent dès qu’on tente de les déployer dans de vrais environnements de production. Bien sûr, on peut faire tourner un chatbot sur un Raspberry Pi, mais que se passe-t-il quand il faut :
- Des performances soutenues sous des charges de travail IA réelles
- Une intégration avec les systèmes industriels existants
- Un fonctionnement fiable dans des environnements difficiles
- Un passage à l’échelle économique sur des centaines d’unités
À Embedded World, nous avons présenté quelque chose de différent : un système d’IA de qualité production qui associe le modèle 3B de Llama 3.2, optimisé pour le edge, à une implémentation RAG complète, fonctionnant entièrement sur du matériel Edge, sans repli vers le cloud.
Pourquoi cette implémentation est importante
L’enjeu n’est pas de faire tourner un LLM sur du matériel Edge : les modèles légers de Llama 3.2 ont été conçus spécifiquement pour les appareils Edge et les applications mobiles. La prouesse d’ingénierie consiste à créer un système d’IA complet qui fonctionne de manière fiable dans des scénarios de production.
Le système complet intègre le modèle 3B de Llama 3.2, optimisé pour le edge, à un pipeline RAG complet qui gère les embeddings vectoriels, la recherche sémantique et la récupération de documents en temps réel à partir de bases de connaissances locales. Il fonctionne en parallèle du traitement simultané de requêtes et d’une intégration transparente avec les systèmes d’IHM industriels, le tout sans dégradation des performances.
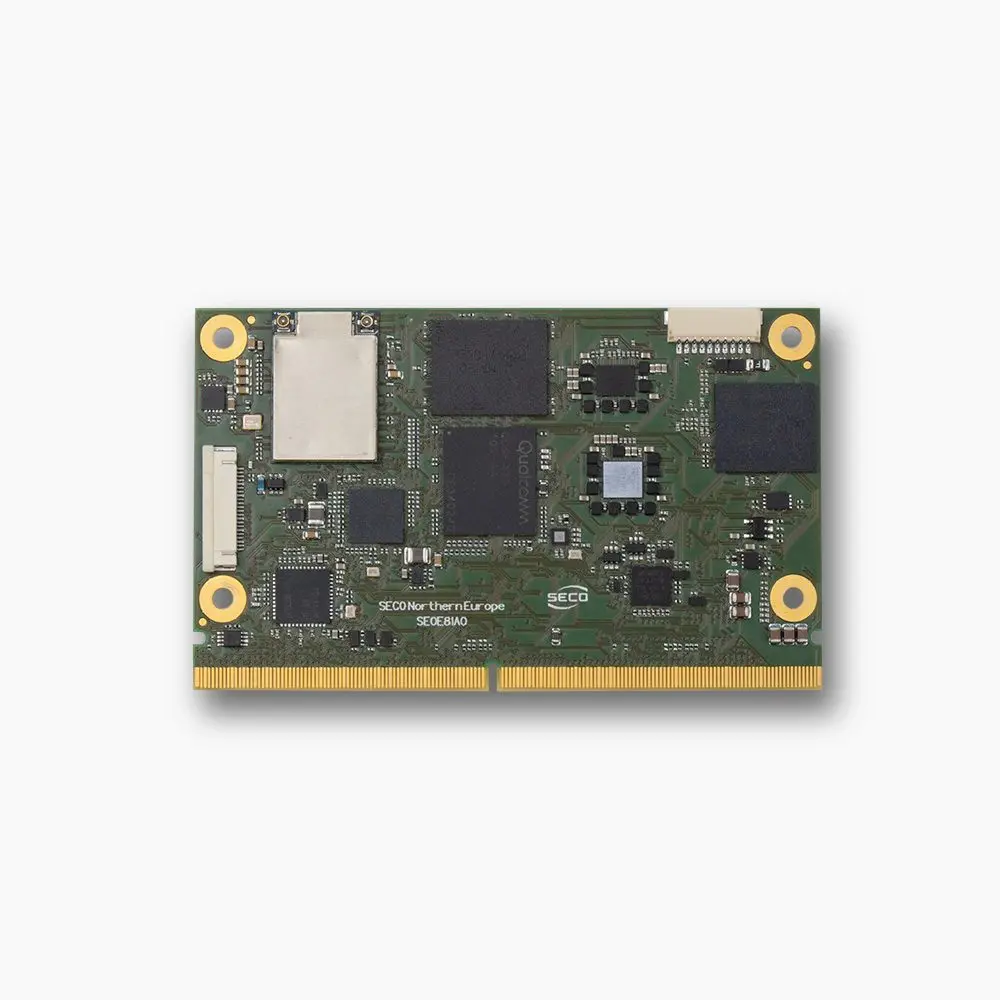
La base matérielle est notre module SOM-SMARC-QCS6490, construit autour du processeur Qualcomm® Dragonwing™ QCS6490 avec son CPU Qualcomm® Kryo™ 670 à 8 cœurs, le processeur Qualcomm® Dragonwing™ QCS6490 intégré et le NPU Qualcomm® Hexagon™ 770 capable de jusqu’à 12 TOPS. Le format SMARC standard facilite l’intégration tout en conservant la fiabilité de qualité industrielle et la gestion thermique qu’exigent les environnements de production.
Plongée dans l’ingénierie
Une architecture logicielle réellement évolutive
Nous l’avons construit sur notre plateforme Clea OS, un système personnalisé basé sur Yocto, avec notre framework Clea AI Studio qui orchestre l’ensemble du pipeline d’IA. L’architecture s’appuie sur le AI Hub de Qualcomm pour des optimisations spécifiques au matériel, tout en utilisant son AI Engine Direct SDK pour répartir intelligemment les charges de travail entre le CPU, le GPU et le NPU. Pour le moteur d’inférence, nous avons mis en œuvre Llama.cpp, avec son approche économe en mémoire et sa prise en charge native de la quantification.
L’implémentation RAG a exigé une ingénierie soignée pour tenir compte des contraintes du edge. Nous avons développé une base de données vectorielle locale avec des seuils de similarité configurables, mis en place un stockage de documents mappé en mémoire pour une récupération instantanée, et créé une architecture de traitement parallèle qui évite tout blocage pendant les opérations de récupération.
Le processus de requête en deux étapes
Lors de la première étape, appelée phase de nettoyage des données, le système nettoie et reformule la saisie de l’utilisateur pour l’optimiser à la fois pour le modèle d’embedding et pour la base de documents locale. Il ne s’agit pas d’un simple nettoyage de texte, mais d’un prétraitement sémantique qui améliore nettement la précision de la récupération. Lors de la seconde étape, les documents pertinents sont récupérés et classés, puis fournis comme contexte au LLM avec la requête d’origine. Le modèle génère des réponses à la fois fondées sur les faits de la base de connaissances locale et adaptées au contexte.
Des performances qui comptent en production
Des chiffres réels issus de tests prolongés, et non de scénarios de démonstration choisis à dessein, montrent une latence de réponse inférieure à 2 secondes pour des requêtes techniques complexes avec récupération de documents. Le système maintient une empreinte mémoire totale de 4GB à pleine charge, pour une consommation de 8-12W pendant le traitement IA actif. Plusieurs utilisateurs peuvent travailler simultanément pendant l’indexation de documents en arrière-plan, sans dégradation des performances, et le système assure un fonctionnement 24/7 en environnement industriel.
Les applications concrètes que nous rendons possibles
Cette implémentation permet plusieurs applications industrielles pratiques, notamment :
Assistant de documentation technique : les opérateurs d’équipements peuvent poser des questions complexes sur les procédures, les étapes de dépannage ou les spécifications. L’IA récupère les sections pertinentes dans les manuels, les schémas et les journaux de maintenance, et fournit des réponses complètes sans avoir besoin de connectivité.
Intelligence de maintenance prédictive : au lieu de simples alertes à seuil, le système met en corrélation les données des capteurs avec des schémas historiques et la documentation de maintenance. Il peut expliquer pourquoi un composant risque de tomber en panne et suggérer des actions correctives précises à partir de bases d’expertise locales.
L’évolution des IHM industrielles : les opérateurs peuvent transformer les interfaces traditionnelles à boutons et menus en interactions en langage naturel, en interrogeant l’état du système, en demandant des rapports ou en obtenant des conseils procéduraux via des interfaces conversationnelles qui comprennent le contexte technique.
La réalité de l’intégration
Le format SMARC signifie que cette solution s’intègre aux conceptions existantes sans refonte majeure de la carte. Nos clients l’intègrent dans des pupitres de commande industriels, des unités de contrôle de véhicules autonomes, des interfaces de dispositifs médicaux et des systèmes de gestion de bâtiments intelligents. Le framework Clea gère la complexité du déploiement des modèles, de la gestion de la mémoire et de l’intégration système, afin que vous puissiez vous concentrer sur la logique de votre application plutôt que de lutter avec l’infrastructure d’IA.
Ce qui vient ensuite
L’implémentation du Dragonwing™ QCS6490 valide le concept, mais nous ne nous arrêtons pas là. Notre développement du Qualcomm® Dragonwing™ QCS5430 cible les déploiements où l’évolutivité des performances sur le terrain est essentielle, car la possibilité de faire évoluer les performances du CPU après le déploiement ouvre de nouvelles perspectives pour les produits industriels à long cycle de vie. Pour les applications qui exigent une réelle puissance de calcul, notre intégration Snapdragon X offrira 45 TOPS pour l’analyse vidéo en temps réel avec traitement LLM simultané dans des systèmes avancés de surveillance ou de contrôle qualité.
Pour les intégrateurs de systèmes : l’essentiel
Les modèles Edge de Llama 3.2 ont été optimisés par des techniques d’élagage et de distillation des connaissances, qui réduisent la taille du modèle tout en conservant les performances, mais les faire fonctionner de façon fiable dans des systèmes de production demande un important travail d’ingénierie, bien au-delà de la simple exécution du modèle.
Nous avons fait ce travail d’ingénierie. Ce n’est pas une preuve de concept : c’est une plateforme prête pour la production, qui élimine la complexité du déploiement de l’IA tout en offrant la performance et la fiabilité qu’exigent les applications industrielles.
L’avenir de l’IA n’est pas centralisé dans des centres de données cloud. Il est distribué, privé, et s’exécute exactement là où vous avez besoin de prendre des décisions. Et il est disponible dès maintenant, sur du matériel que vous pouvez déployer aujourd’hui.
Les détails de l’implémentation technique vous intéressent ? Notre équipe d’ingénierie documente les techniques d’optimisation, les méthodologies de benchmark et les modèles d’intégration. Contactez-nous pour discuter de vos besoins spécifiques en Edge AI.
Présenté dans cet article
SOM-SMARC-QCS6490
Module SMARC® 2.1.1 propulsé par le processeur Qualcomm® Dragonwing™ QCS6490.
- SMARC®
- Qualcomm® QCS6490
À lire aussi

Actualités, 12 novembre 2026
Le module COM Express de SECO basé sur AMD Ryzen Embedded 8000 Series est désormais disponible sous forme d’échantillons
Lire
Actualités, 10 novembre 2026
SECO annonce que Modular Link IQ-615 et Modular Link MX93 sont désormais disponibles à la commande
Lire
Actualités, 5 novembre 2026
SECO et Peridio s’associent pour accélérer la robotique et la Physical AI, du développement au déploiement sur Qualcomm® Dragonwing™
Lire
Recevez la newsletter SECO.
Inscrivez-vous avec votre adresse e-mail sur seco.com.