
- AI
- Edge Computing
- Industries
- Clea
Edge AI richtig gemacht: So haben wir produktionsreifes LLM+RAG auf einem SMARC-Modul umgesetzt
Wir haben Llama 3.2 3B mit einer vollständigen RAG-Pipeline (Retrieval-Augmented Generation) auf Edge-Hardware mit Qualcomm® Dragonwing™ QCS6490 umgesetzt und damit gezeigt, dass anspruchsvolle AI-Anwendungen ohne Cloud-Abhängigkeiten zuverlässig in Produktionsumgebungen laufen können. Hier ist die technische Realität hinter dem Gelingen.
Die eigentliche technische Herausforderung
Der Hype um „AI at the Edge“ baut sich seit Jahren auf, doch die meisten Implementierungen scheitern, sobald man sie in realen Produktionsumgebungen einsetzen will. Sicher, man kann einen Chatbot auf einem Raspberry Pi betreiben, aber was, wenn man Folgendes braucht:
- Dauerhafte Leistung unter realen AI-Workloads
- Integration in bestehende Industriesysteme
- Zuverlässigen Betrieb in rauen Umgebungen
- Kosteneffiziente Skalierung auf Hunderte von Einheiten
Auf der Embedded World haben wir etwas anderes gezeigt: ein AI-System in Produktionsqualität, das das auf den Edge optimierte 3B-Modell von Llama 3.2 mit einer vollständigen RAG-Implementierung kombiniert und vollständig auf Edge-Hardware läuft, ohne Cloud-Fallback.
Warum diese Implementierung wichtig ist
Die Bedeutung liegt nicht darin, ein LLM auf Edge-Hardware auszuführen - die leichtgewichtigen Modelle von Llama 3.2 wurden gezielt für Edge-Geräte und mobile Anwendungen entwickelt. Die technische Leistung besteht darin, ein vollständiges AI-System zu schaffen, das in Produktionsszenarien zuverlässig funktioniert.
Das Gesamtsystem integriert das auf den Edge optimierte 3B-Modell von Llama 3.2 mit einer vollständigen RAG-Pipeline, die Vektor-Embeddings, semantische Suche und den Echtzeit-Abruf von Dokumenten aus lokalen Wissensdatenbanken übernimmt. Das läuft parallel zur gleichzeitigen Verarbeitung von Abfragen und zur nahtlosen Integration in industrielle HMI-Systeme, alles ohne Leistungseinbußen.
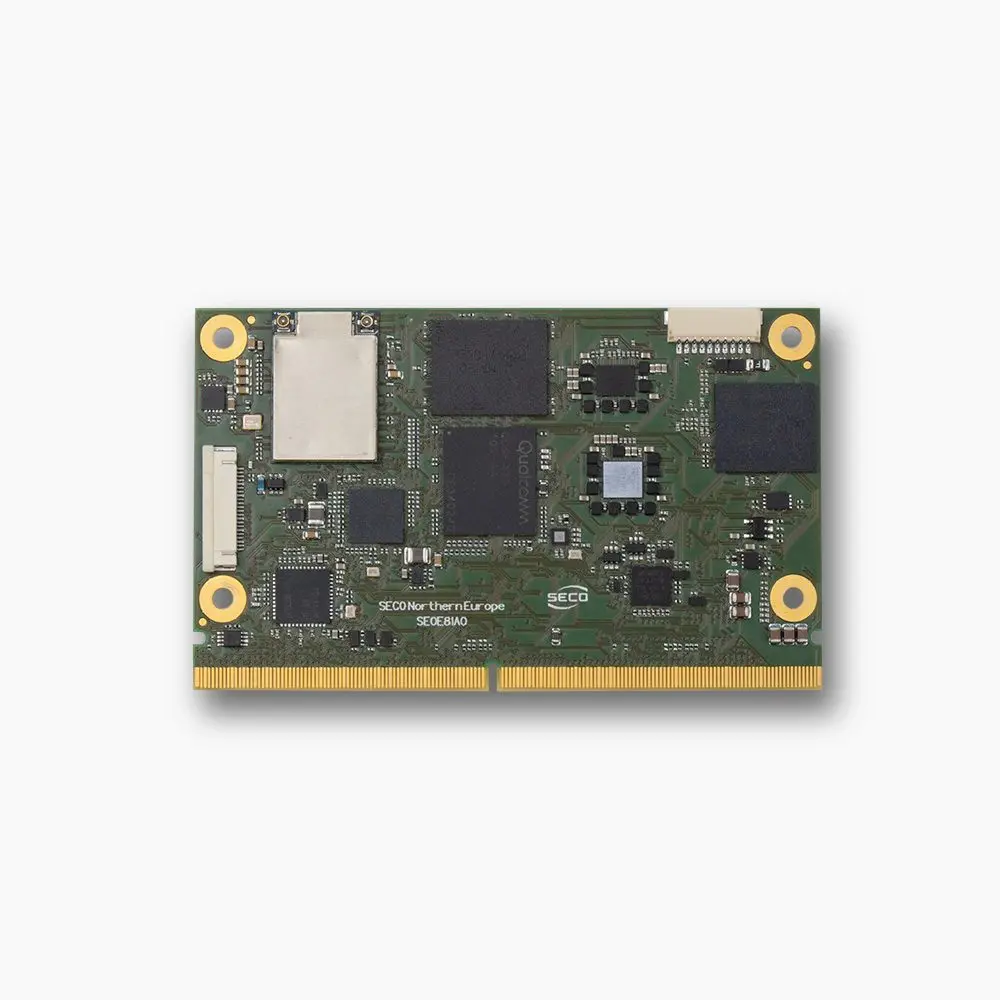
Die Hardware-Basis ist unser Modul SOM-SMARC-QCS6490, aufgebaut um den Prozessor Qualcomm® Dragonwing™ QCS6490 mit seiner 8-Kern-CPU Qualcomm® Kryo™ 670, dem integrierten Prozessor Qualcomm® Dragonwing™ QCS6490 und der NPU Qualcomm® Hexagon™ 770 mit bis zu 12 TOPS. Der standardisierte SMARC-Formfaktor ermöglicht eine einfache Integration und bewahrt zugleich die industrielle Zuverlässigkeit und das Wärmemanagement, die Produktionsumgebungen verlangen.
Der technische Deep Dive
Eine Software-Architektur, die wirklich skaliert
Wir haben dies auf unserer Plattform Clea OS aufgebaut, einem maßgeschneiderten Yocto-basierten System, wobei unser Framework Clea AI Studio die gesamte AI-Pipeline orchestriert. Die Architektur nutzt den AI Hub von Qualcomm für hardwarespezifische Optimierungen und verteilt mithilfe des AI Engine Direct SDK die Workloads intelligent auf CPU, GPU und NPU. Als Inferenz-Engine haben wir Llama.cpp mit seinem speichereffizienten Ansatz und der integrierten Unterstützung für Quantisierung implementiert.
Die RAG-Implementierung erforderte sorgfältiges Engineering für die Einschränkungen am Edge. Wir haben eine lokale Vektordatenbank mit konfigurierbaren Ähnlichkeitsschwellen entwickelt, eine speicherabgebildete Dokumentenablage für den sofortigen Abruf implementiert und eine Architektur für Parallelverarbeitung geschaffen, die jegliche Blockierung während des Abrufs verhindert.
Der zweistufige Abfrageprozess
In der ersten Stufe, der Phase der Datenbereinigung, bereinigt und reformuliert das System die Nutzereingabe und optimiert sie sowohl für das Embedding-Modell als auch für die lokale Dokumentendatenbank. Dies ist nicht bloß Textbereinigung, sondern eine semantische Vorverarbeitung, die die Treffgenauigkeit deutlich verbessert. In der zweiten Stufe werden relevante Dokumente abgerufen und bewertet und dann zusammen mit der ursprünglichen Anfrage als Kontext an das LLM übergeben. Das Modell erzeugt Antworten, die sowohl sachlich in der lokalen Wissensbasis verankert als auch kontextuell angemessen sind.
Leistung, die in der Produktion zählt
Reale Zahlen aus Dauertests, nicht aus handverlesenen Demo-Szenarien, zeigen eine Antwortlatenz von unter 2 Sekunden bei komplexen technischen Anfragen mit Dokumentenabruf. Das System hält unter Volllast einen Gesamtspeicherbedarf von 4 GB und verbraucht bei aktiver AI-Verarbeitung 8-12 W. Mehrere Nutzer können gleichzeitig arbeiten, während im Hintergrund Dokumente indiziert werden, ohne Leistungseinbußen, und das System läuft in Industrieumgebungen rund um die Uhr (24/7).
Praxisanwendungen, die wir ermöglichen
Diese Implementierung ermöglicht eine Reihe praktischer industrieller Anwendungen, darunter:
Assistent für technische Dokumentation - Maschinenbediener können komplexe Fragen zu Verfahren, Fehlerbehebung oder Spezifikationen stellen. Die AI ruft relevante Abschnitte aus Handbüchern, Schaltplänen und Wartungsprotokollen ab und liefert umfassende Antworten, ohne dass eine Verbindung nötig ist.
Intelligenz für vorausschauende Wartung - Statt einfacher Schwellenwert-Alarme korreliert das System Sensordaten mit historischen Mustern und Wartungsdokumentation. Es kann erklären, warum eine Komponente möglicherweise ausfällt, und auf Basis lokaler Expertendatenbanken konkrete Korrekturmaßnahmen vorschlagen.
Evolution industrieller HMI - Bediener können herkömmliche Schalter-und-Menü-Oberflächen in Interaktionen in natürlicher Sprache verwandeln, den Systemstatus abfragen, Berichte anfordern oder Handlungsanleitungen erhalten, über dialogorientierte Schnittstellen, die den technischen Kontext verstehen.
Die Realität der Integration
Der SMARC-Formfaktor bedeutet, dass sich dies ohne größere Board-Neuentwicklungen in bestehende Designs einfügt. Unsere Kunden integrieren dies in industrielle Schalttafeln, Steuergeräte autonomer Fahrzeuge, Schnittstellen medizinischer Geräte und Gebäudemanagementsysteme. Das Clea Framework übernimmt die Komplexität von Modell-Deployment, Speicherverwaltung und Systemintegration, sodass Sie sich auf Ihre Anwendungslogik konzentrieren können, statt mit der AI-Infrastruktur zu kämpfen.
Was als Nächstes kommt
Die Implementierung des Dragonwing™ QCS6490 beweist das Konzept, aber wir bleiben hier nicht stehen. Unsere Entwicklung des Qualcomm® Dragonwing™ QCS5430 zielt auf Einsätze, bei denen die Leistungsskalierung im Feld entscheidend ist, denn die Möglichkeit, die CPU-Leistung nach dem Deployment aufzurüsten, eröffnet neue Möglichkeiten für industrielle Produkte mit langem Lebenszyklus. Für Anwendungen, die ernsthafte Rechenleistung benötigen, liefert unsere Snapdragon-X-Integration 45 TOPS für Echtzeit-Videoanalyse mit gleichzeitiger LLM-Verarbeitung in fortschrittlichen Überwachungs- oder Qualitätskontrollsystemen.
Für Systemintegratoren: das Fazit
Die Edge-Modelle von Llama 3.2 wurden durch Pruning und Knowledge Distillation optimiert, die die Modellgröße verringern und dabei die Leistung erhalten. Sie zuverlässig in Produktionssystemen zum Laufen zu bringen, erfordert jedoch erheblichen Engineering-Aufwand, der über das bloße Ausführen des Modells hinausgeht.
Diese Engineering-Arbeit haben wir geleistet. Dies ist kein Proof of Concept - es ist eine produktionsreife Plattform, die die Komplexität des AI-Deployments beseitigt und zugleich die Leistung und Zuverlässigkeit bietet, die industrielle Anwendungen verlangen.
Die Zukunft der AI liegt nicht zentralisiert in Cloud-Rechenzentren. Sie ist verteilt, privat und läuft genau dort, wo Sie Entscheidungen treffen müssen. Und sie ist jetzt verfügbar, auf Hardware, die Sie schon heute einsetzen können.
Interessieren Sie sich für die technischen Implementierungsdetails? Unser Engineering-Team dokumentiert die Optimierungstechniken, Benchmarking-Methoden und Integrationsmuster. Nehmen Sie Kontakt mit uns auf, um Ihre spezifischen Edge-AI-Anforderungen zu besprechen.
In diesem Artikel
In diesem Artikel vorgestellt
SOM-SMARC-QCS6490
SMARC® 2.1.1 Modul mit Qualcomm® Dragonwing™ QCS6490 Prozessor.
- SMARC®
- Qualcomm® QCS6490
Weiterlesen

News, 12. November 2026
SECOs COM Express-Modul auf Basis der AMD Ryzen Embedded 8000 Series ist jetzt zur Bemusterung verfügbar
Lesen
News, 5. November 2026
SECO und Peridio beschleunigen Robotik und Physical AI von der Entwicklung bis zum Einsatz auf Qualcomm® Dragonwing™
Lesen
Blog
Industrial Edge AI 2027: Wofür OEMs jetzt entwickeln müssen
Lesen
Abonnieren Sie den SECO Newsletter.
Melden Sie sich mit Ihrer E-Mail-Adresse auf seco.com an.