
- AI
- Edge Computing
- Industries
- Clea
把 Edge AI 做对:我们如何在 SMARC 模块上构建量产就绪的 LLM+RAG
我们在 Qualcomm® Dragonwing™ QCS6490 边缘硬件上实现了 Llama 3.2 3B 及完整的 RAG(检索增强生成)流水线,证明复杂的 AI 应用可以在无需依赖云的情况下,在量产环境中可靠运行。以下是让它成功运行背后的工程实践。
真正的工程挑战
围绕“边缘 AI”的热潮已持续多年,但大多数实现一旦尝试部署到实际的量产环境中就会有所欠缺。当然,您可以在 Raspberry Pi 上运行聊天机器人,但如果您需要:
- 在真实 AI 工作负载下的持续性能
- 与现有工业系统的集成
- 在恶劣环境中的可靠运行
- 在数百台设备上经济高效地扩展
在 Embedded World 上,我们展示了与众不同的东西:一个量产级 AI 系统,它将 Llama 3.2 的 3B 边缘优化模型与完整的 RAG 实现相结合,完全在边缘硬件上运行,没有云端回退。
为什么这一实现很重要
重要之处不在于在边缘硬件上运行 LLM,Llama 3.2 的轻量级模型本就是专为边缘设备和移动应用而构建的。工程上的成就在于创建了一个在量产场景中可靠运行的完整 AI 系统。
完整的系统将 Llama 3.2 的 3B 边缘优化模型与完整的 RAG 流水线集成在一起,后者负责处理向量嵌入、语义搜索,以及从本地知识库中实时检索文档。它与并发查询处理以及与工业 HMI 系统的无缝集成同时运行,且性能不会下降。
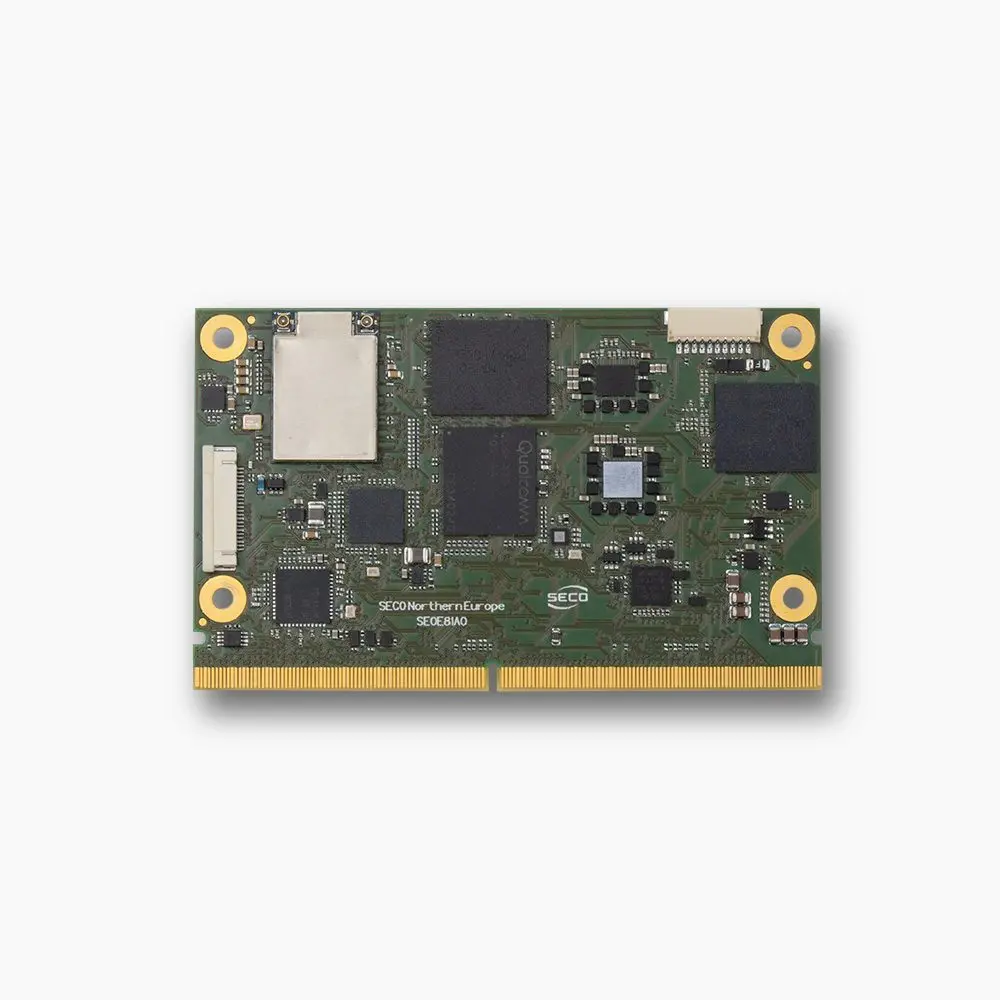
硬件基础是我们的 SOM-SMARC-QCS6490 模块,围绕 Qualcomm's® Dragonwing™ QCS6490 处理器构建,具有 8 核 Qualcomm® Kryo™ 670 CPU、集成的 Qualcomm's® Dragonwing™ QCS6490 处理器,以及性能最高可达 12 TOPS 的 Qualcomm® Hexagon™ 770 NPU。标准的 SMARC 外形规格便于集成,同时保持量产环境所要求的工业级可靠性和散热管理。
工程深度解析
真正可扩展的软件架构
我们在自己的 Clea OS 平台(一个基于 Yocto 的定制系统)上构建了这一方案,由 Clea AI Studio 框架编排整个 AI 流水线。该架构利用 Qualcomm 的 AI Hub 进行针对硬件的优化,同时使用其 AI Engine Direct SDK 在 CPU、GPU 和 NPU 之间智能分配工作负载。对于推理引擎,我们实现了 Llama.cpp,它具有内存高效的方式和内置的量化支持。
RAG 的实现需要针对边缘限制进行精心的工程设计。我们开发了具有可配置相似度阈值的本地向量数据库,实现了用于即时检索的内存映射文档存储,并创建了并行处理架构,以防止检索操作期间出现任何阻塞。
两阶段查询流程
在称为数据清洗阶段的第一阶段,系统对用户输入进行清洗和重构,针对嵌入模型和本地文档数据库对其进行优化。这不仅仅是文本清洗,而是语义预处理,可显著提高检索准确性。在第二阶段,系统检索相关文档并对其排序,然后与原始查询一起作为上下文输入 LLM。模型生成的响应既有本地知识库中的事实依据,又符合上下文。
在量产中至关重要的性能
来自持续测试的真实数据(而非精心挑选的演示场景)显示,对于带文档检索的复杂技术查询,响应延迟低于 2 秒。系统在满负载下保持 4GB 的总内存占用,在 AI 处理活跃期间功耗为 8-12W。多个用户可以在后台文档索引的同时并发操作,而性能不会下降,并且系统可在工业环境中保持 7×24 小时运行。
我们正在实现的真实应用
这一实现可支持许多实用的工业应用,包括:
技术文档助手 - 设备操作人员可以就操作规程、故障排除步骤或规格提出复杂问题。AI 从手册、原理图和维护日志中检索相关章节,在无需连接网络的情况下提供全面的解答。
预测性维护智能 - 系统不再只是简单的阈值告警,而是将传感器数据与历史模式和维护文档相关联。它可以解释某个部件为何可能出现故障,并根据本地专业知识库建议具体的纠正措施。
工业 HMI 的演进 - 操作人员可以将传统的按钮加菜单式界面转变为自然语言交互,通过理解技术情境的对话式界面查询系统状态、请求报告或获取操作指导。
集成的现实
SMARC 外形规格意味着它无需对电路板进行大幅重新设计即可嵌入现有设计。我们的客户正在将其集成到工业控制面板、自动驾驶车辆控制单元、医疗设备界面以及智能楼宇管理系统中。Clea 框架处理模型部署、内存管理和系统集成的复杂性,使您可以专注于应用逻辑,而不是与 AI 基础设施较劲。
接下来是什么
Dragonwing™ QCS6490 的实现验证了这一概念,但我们不会止步于此。我们开发的 Qualcomm® Dragonwing™ QCS5430 面向现场性能扩展至关重要的部署,因为部署后升级 CPU 性能的能力为长生命周期的工业产品开辟了新的可能性。对于需要强大算力的应用,我们的 Snapdragon X 集成将为先进的监控或质量控制系统中同时进行 LLM 处理的实时视频分析提供 45 TOPS 算力。
致系统集成商:底线
Llama 3.2 的边缘模型通过剪枝和知识蒸馏技术进行了优化,这些技术在缩小模型尺寸的同时保持性能,但要使其在量产系统中可靠运行,需要的不仅仅是运行模型,还需要大量的工程投入。
我们已经完成了这些工程工作。这不是概念验证,而是一个量产就绪的平台,它消除了 AI 部署的复杂性,同时提供工业应用所要求的性能和可靠性。
AI 的未来并不集中在云数据中心。它是分布式的、私密的,并且就运行在您需要它做出决策的地方。而且它现在就能在您今天即可部署的硬件上使用。
对技术实现细节感兴趣吗?我们的工程团队正在整理优化技术、基准测试方法和集成模式。欢迎与我们联系,讨论您具体的 Edge AI 需求。



订阅 SECO 新闻通讯。
在 seco.com 上用您的电子邮件地址订阅。