
- AI
- Edge Computing
- Industries
- Clea
Edge AIを正しく実現する:SMARCモジュール上で本番運用可能なLLM+RAGを構築した方法
当社は、Qualcomm® Dragonwing™ QCS6490のEdgeハードウェア上に、完全なRAG(Retrieval-Augmented Generation)パイプラインを備えたLlama 3.2 3Bを実装し、高度なAIアプリケーションがクラウドに依存せずに本番環境で確実に動作することを実証しました。これを実現するためのエンジニアリングの実態をご紹介します。
真のエンジニアリング上の課題
「EdgeでのAI」をめぐる期待は何年も前から高まっていますが、実際の本番環境に導入しようとすると、ほとんどの実装は期待に届きません。もちろん、Raspberry Piでチャットボットを動かすことはできますが、次のような要件が求められる場合はどうでしょうか。
- 実際のAIワークロード下での持続的な性能
- 既存の産業システムとの統合
- 過酷な環境での信頼性の高い動作
- 数百台規模へのコスト効率の高いスケーリング
Embedded Worldで、当社は従来とは異なるものを披露しました。Llama 3.2のEdge向けに最適化された3Bモデルと完全なRAG実装を組み合わせ、クラウドへのフォールバックなしにEdgeハードウェア上だけで動作する、本番グレードのAIシステムです。
この実装が重要な理由
重要なのは、EdgeハードウェアでLLMを動かすこと自体ではありません。Llama 3.2の軽量モデルは、Edgeデバイスやモバイルアプリケーション向けに特別に作られているからです。エンジニアリング上の成果は、本番のシナリオで確実に動作する完全なAIシステムを構築した点にあります。
このシステム全体は、Llama 3.2のEdge向けに最適化された3Bモデルと、ベクトル埋め込み、セマンティック検索、ローカルのナレッジベースからのリアルタイムな文書検索を処理する完全なRAGパイプラインを統合しています。これが、同時クエリ処理や産業用HMIシステムとのシームレスな統合と並行して動作しますが、性能の低下はありません。
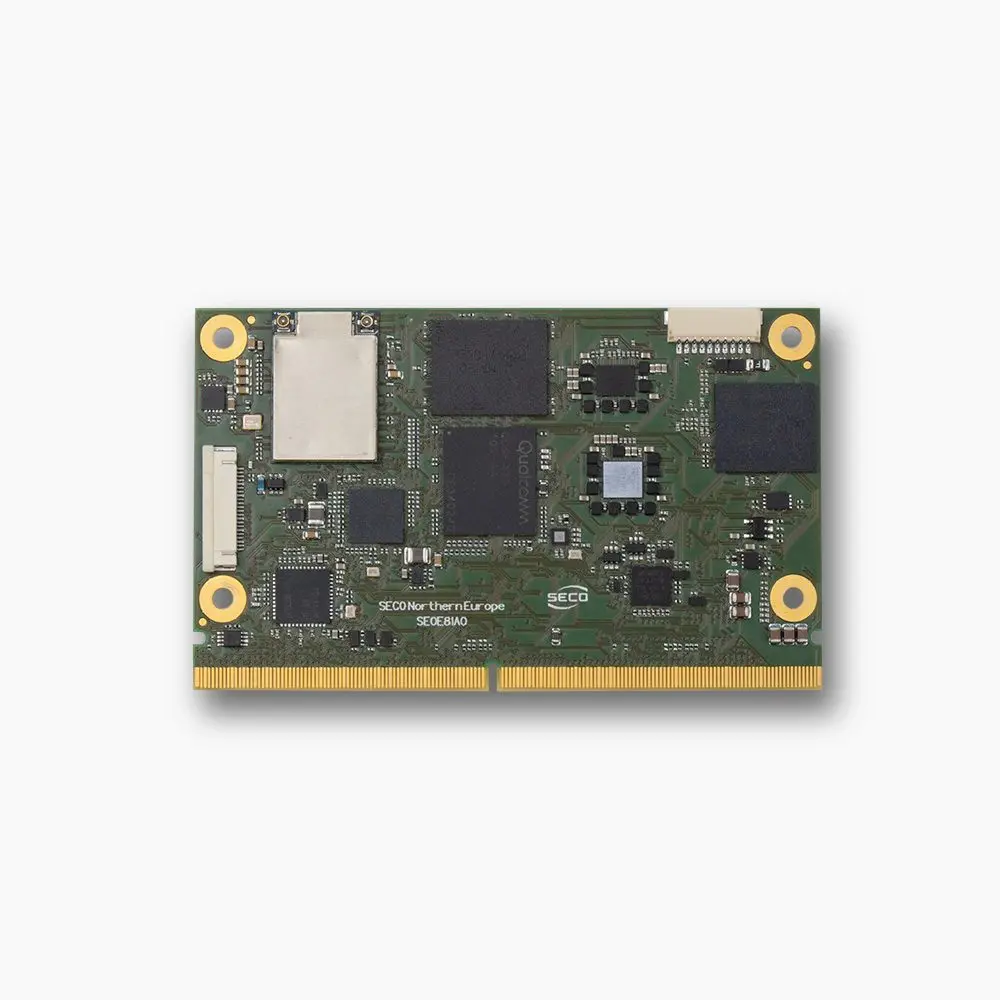
ハードウェアの基盤は、当社のSOM-SMARC-QCS6490モジュールです。Qualcomm®のDragonwing™ QCS6490プロセッサーを中心に構築されており、8コアのQualcomm® Kryo™ 670 CPU、統合されたQualcomm®のDragonwing™ QCS6490プロセッサー、最大12 TOPSの性能を持つQualcomm® Hexagon™ 770 NPUを備えています。標準的なSMARCフォームファクターにより容易な統合が可能で、本番環境が求める産業グレードの信頼性と熱管理も維持されます。
エンジニアリングの詳細解説
実際にスケールするソフトウェアアーキテクチャ
当社は、Yoctoをベースとするカスタムシステムである当社のClea OSプラットフォーム上にこれを構築し、Clea AI Studioフレームワークでパイプライン全体のAIをオーケストレーションしています。このアーキテクチャは、ハードウェア固有の最適化にQualcommのAI Hubを活用し、同社のAI Engine Direct SDKを使って、CPU、GPU、NPUにワークロードをインテリジェントに分散させます。推論エンジンには、メモリ効率に優れたアプローチと組み込みの量子化サポートを備えたLlama.cppを実装しました。
RAGの実装には、Edgeの制約に合わせた入念なエンジニアリングが必要でした。当社は、類似度のしきい値を設定可能なローカルのベクトルデータベースを開発し、即時の検索を可能にするメモリマップ方式の文書ストレージを実装し、検索処理中にいかなるブロッキングも生じさせない並列処理アーキテクチャを構築しました。
2段階のクエリ処理
データクリーニングフェーズと呼ばれる第1段階では、システムがユーザーの入力をクリーニングして再構成し、埋め込みモデルとローカルの文書データベースの両方に最適化します。これは単なるテキストのクリーニングではなく、検索精度を大幅に向上させるセマンティックな前処理です。第2段階では、関連する文書が検索されてランク付けされ、元のクエリとともにコンテキストとしてLLMに渡されます。モデルは、ローカルのナレッジベースに基づく事実に即し、かつ文脈にふさわしい回答を生成します。
本番運用で意味を持つ性能
都合のよいデモシナリオだけを選んだのではなく、持続的なテストで得た実際の数値では、文書検索を伴う複雑な技術的クエリで、応答レイテンシーは2秒未満でした。システムは、フルロード時でも総メモリ使用量を4GBに維持し、AI処理の実行中の消費電力は8~12Wです。バックグラウンドでの文書インデックス作成と並行して、複数のユーザーが同時に操作しても性能は低下せず、産業環境で24/7の稼働を維持します。
当社が可能にする実際のアプリケーション
この実装により、次のような実用的な産業用アプリケーションが実現します。
技術文書アシスタント:機器のオペレーターは、手順、トラブルシューティングの手順、仕様に関する複雑な質問ができます。AIは、マニュアル、回路図、保守ログから関連する箇所を検索し、接続環境がなくても包括的な回答を提供します。
予知保全インテリジェンス:単純なしきい値アラートの代わりに、システムはセンサーデータを過去のパターンや保守文書と関連付けます。部品が故障しそうな理由を説明し、ローカルの専門知識データベースに基づいて具体的な是正措置を提案できます。
産業用HMIの進化:オペレーターは、従来のボタンとメニューによるインターフェースを自然言語での対話に変えられます。技術的な文脈を理解する対話型インターフェースを通じて、システムの状態の照会、レポートの要求、手順のガイダンスの取得ができます。
統合の実態
SMARCフォームファクターのため、大がかりなボード再設計をせずに既存の設計に組み込めます。お客様は、これを産業用制御盤、自律走行車の制御ユニット、医療機器のインターフェース、スマートビル管理システムに統合しています。Cleaフレームワークが、モデルのデプロイメント、メモリ管理、システム統合の複雑さを処理するため、AIインフラに悩まされることなく、アプリケーションのロジックに集中できます。
今後の展開
Dragonwing™ QCS6490の実装によってコンセプトは実証されましたが、当社はここで立ち止まりません。当社が開発を進めるQualcomm® Dragonwing™ QCS5430は、導入後にCPU性能をアップグレードできることが、長いライフサイクルの産業用製品に新たな可能性をもたらすため、現場での性能スケーリングが重要な導入を対象としています。高い演算能力を必要とするアプリケーション向けには、Snapdragon Xの統合により、高度な監視や品質管理システムでのリアルタイム映像解析と同時LLM処理に向けて、45 TOPSを提供します。
システムインテグレーター向け:結論
Llama 3.2のEdge向けモデルは、性能を維持しながらモデルサイズを縮小するプルーニングや知識蒸留の技術によって最適化されていますが、それを本番システムで確実に動作させるには、モデルを実行するだけにとどまらない、相当なエンジニアリング作業が必要です。
当社は、そのエンジニアリング作業を完了しています。これは概念実証ではなく、AI導入の複雑さを解消しつつ、産業用アプリケーションが求める性能と信頼性を提供する、本番運用可能なプラットフォームです。
AIの未来は、クラウドのデータセンターに集中するものではありません。分散され、プライベートで、判断を下す必要がまさにその場所で動作するものです。そしてそれは、今日導入できるハードウェアで、すでに利用可能です。
技術的な実装の詳細にご関心がありますか。当社のエンジニアリングチームは、最適化技術、ベンチマーク手法、統合パターンを文書化しています。お客様固有のEdge AI要件についてご相談いただくため、ぜひご連絡ください。



SECO ニュースレターを受け取る。
seco.com でメールアドレスを登録してください。