
- AI
- Edge Computing
- Industries
- Clea
Edge AI fatta bene: come abbiamo costruito un LLM+RAG pronto per la produzione su un modulo SMARC
Abbiamo implementato Llama 3.2 3B con una pipeline RAG (Retrieval-Augmented Generation) completa su hardware edge Qualcomm® Dragonwing™ QCS6490, dimostrando che applicazioni AI sofisticate possono funzionare in modo affidabile in ambienti di produzione senza dipendere dal cloud. Ecco la realtà ingegneristica dietro a ciò che lo rende possibile.
La vera sfida ingegneristica
L’entusiasmo per l’"AI all’edge" cresce da anni, ma la maggior parte delle implementazioni non regge quando si prova a distribuirle in ambienti di produzione reali. Certo, si può far girare un chatbot su un Raspberry Pi, ma che cosa succede quando servono:
- Prestazioni sostenute con carichi di lavoro AI reali
- Integrazione con i sistemi industriali esistenti
- Funzionamento affidabile in ambienti difficili
- Scalabilità economicamente efficace su centinaia di unità
A Embedded World abbiamo dimostrato qualcosa di diverso: un sistema AI di livello produttivo che combina il modello da 3B ottimizzato per l'edge di Llama 3.2 con un’implementazione RAG completa, in esecuzione interamente su hardware edge senza ricorrere al cloud.
Perché questa implementazione è importante
Il punto non è far girare un LLM su hardware edge: i modelli leggeri di Llama 3.2 sono stati costruiti appositamente per dispositivi edge e per l'uso in applicazioni mobile. Il risultato ingegneristico sta nel creare un sistema AI completo che funzioni in modo affidabile negli scenari di produzione.
Il sistema completo integra il modello da 3B ottimizzato per l'edge di Llama 3.2 con una pipeline RAG completa che gestisce embedding vettoriali, ricerca semantica e recupero in tempo reale di documenti da basi di conoscenza locali. Il tutto funziona insieme all’elaborazione simultanea di query e all’integrazione fluida con i sistemi HMI industriali, senza alcun degrado delle prestazioni.
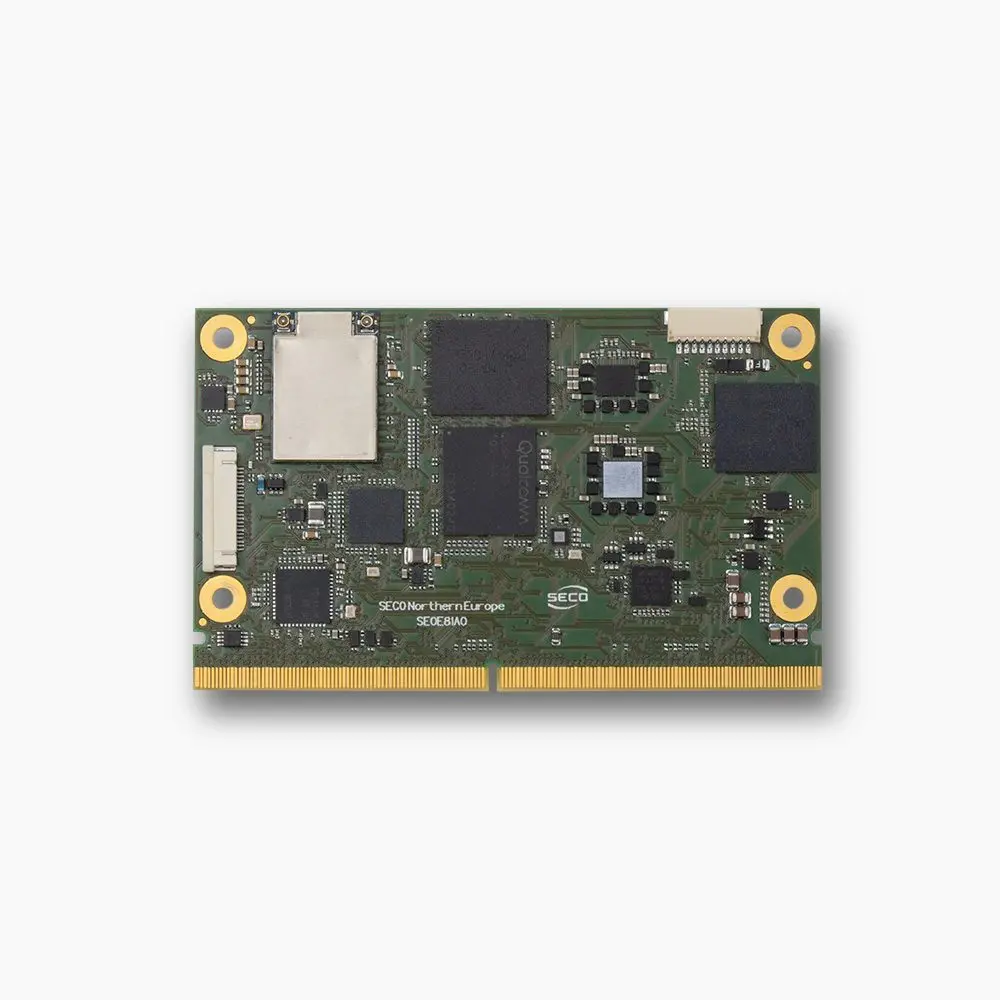
La base hardware è il nostro modulo SOM-SMARC-QCS6490, costruito attorno al processore Qualcomm® Dragonwing™ QCS6490 con la sua CPU Qualcomm® Kryo™ 670 a 8 core, la GPU integrata del processore Qualcomm® Dragonwing™ QCS6490 e l'NPU Qualcomm® Hexagon™ 770 in grado di raggiungere 12 TOPS. Il formato standard SMARC consente una facile integrazione mantenendo l’affidabilità di grado industriale e la gestione termica che gli ambienti di produzione richiedono.
L’approfondimento ingegneristico
Un’architettura software che scala davvero
L'abbiamo costruito sulla nostra piattaforma Clea OS, un sistema personalizzato basato su Yocto, con il nostro framework Clea AI Studio che orchestra l’intera pipeline AI. L’architettura sfrutta l’AI Hub di Qualcomm per le ottimizzazioni specifiche dell’hardware, usando il loro AI Engine Direct SDK per distribuire in modo intelligente i carichi di lavoro tra CPU, GPU e NPU. Come motore di inferenza abbiamo implementato Llama.cpp, con il suo approccio efficiente in termini di memoria e il supporto integrato alla quantizzazione.
L’implementazione RAG ha richiesto un’attenta progettazione per i vincoli dell’edge. Abbiamo sviluppato un database vettoriale locale con soglie di similarità configurabili, implementato un archivio di documenti mappato in memoria per un recupero istantaneo e creato un’architettura di elaborazione parallela che impedisce qualsiasi blocco durante le operazioni di recupero.
Il processo di query in due fasi
Nella prima fase, detta fase di pulizia dei dati, il sistema pulisce e riformula l’input dell’utente, ottimizzandolo sia per il modello di embedding sia per il database locale di documenti. Non si tratta solo di pulizia del testo, ma di una pre-elaborazione semantica che migliora in modo significativo l'accuratezza del recupero. Nella seconda fase i documenti rilevanti vengono recuperati e ordinati, poi forniti come contesto all’LLM insieme alla query originale. Il modello genera risposte sia fondate sui fatti della base di conoscenza locale sia appropriate al contesto.
Prestazioni che contano in produzione
Numeri reali da test prolungati, non da scenari dimostrativi scelti ad arte, mostrano una latenza di risposta inferiore a 2 secondi per query tecniche complesse con recupero di documenti. Il sistema mantiene un’impronta di memoria totale di 4GB a pieno carico, consumando 8-12W durante l’elaborazione AI attiva. Più utenti possono operare contemporaneamente insieme all’indicizzazione dei documenti in background senza degrado delle prestazioni, e il sistema mantiene un funzionamento 24/7 in ambienti industriali.
Le applicazioni reali che stiamo abilitando all'edge
Questa implementazione rende possibili numerose applicazioni industriali pratiche, tra cui:
Assistente alla documentazione tecnica - Gli operatori delle apparecchiature possono porre domande complesse su procedure, passaggi di risoluzione dei problemi o specifiche. L’AI recupera le sezioni rilevanti da manuali, schemi e registri di manutenzione, fornendo risposte complete senza bisogno di connettività.
Intelligenza per la manutenzione predittiva - Invece dei semplici avvisi a soglia, il sistema correla i dati dei sensori con gli andamenti storici e con la documentazione di manutenzione. Può spiegare perché un componente potrebbe guastarsi e suggerire azioni correttive specifiche basate su database di competenze locali.
Evoluzione delle HMI industriali - Gli operatori possono trasformare le tradizionali interfacce a pulsanti e menu in interazioni in linguaggio naturale, interrogando lo stato del sistema, richiedendo report o ottenendo indicazioni procedurali tramite interfacce conversazionali che comprendono il contesto tecnico.
La realtà dell’integrazione
Il formato SMARC significa che tutto questo si inserisce nei progetti esistenti senza importanti riprogettazioni delle schede. I nostri clienti lo stanno integrando in pannelli di controllo industriali, unità di controllo di veicoli autonomi, interfacce di dispositivi medicali e sistemi di gestione di smart building. Il framework Clea gestisce la complessità di deployment dei modelli, gestione della memoria e integrazione di sistema, così puoi concentrarti sulla logica della tua applicazione invece di lottare con l’infrastruttura AI.
Cosa c'è in arrivo
L’implementazione del Dragonwing™ QCS6490 dimostra il concetto, ma non ci fermiamo qui. Il nostro sviluppo del Qualcomm® Dragonwing™ QCS5430 punta ai deployment in cui è fondamentale scalare le prestazioni sul campo, perché la possibilità di aggiornare le prestazioni della CPU dopo il deployment apre nuove possibilità per i prodotti industriali a lungo ciclo di vita. Per le applicazioni che richiedono una potenza di calcolo elevata, la nostra integrazione di Snapdragon X offrirà 45 TOPS per l'analisi video in tempo reale con elaborazione LLM simultanea in sistemi avanzati di sorveglianza o di controllo qualità.
Per i system integrator: in sintesi
I modelli per l'edge di Llama 3.2 sono stati ottimizzati con tecniche di pruning e distillazione della conoscenza che riducono le dimensioni del modello mantenendo le prestazioni, ma farli funzionare in modo affidabile nei sistemi di produzione richiede un notevole lavoro ingegneristico, ben oltre il semplice far girare il modello.
Quel lavoro ingegneristico lo abbiamo già fatto. Non è una prova di concetto: è una piattaforma pronta per la produzione che elimina la complessità del deployment dell’AI offrendo al tempo stesso le prestazioni e l'affidabilità richieste dalle applicazioni industriali.
Il futuro dell'AI non è centralizzato nei data center cloud. È distribuito, privato e gira esattamente dove serve per prendere decisioni. Ed è disponibile ora su hardware che puoi impiegare oggi.
Ti interessano i dettagli dell’implementazione tecnica? Il nostro team di ingegneria sta documentando le tecniche di ottimizzazione, le metodologie di benchmarking e i pattern di integrazione. Mettiti in contatto con noi per discutere le tue specifiche esigenze di edge AI.
In evidenza in questo articolo
SOM-SMARC-QCS6490
Modulo SMARC® 2.1.1 basato sul processore Qualcomm® Dragonwing™ QCS6490.
- SMARC®
- Qualcomm® QCS6490
Continua a leggere

News, 12 novembre 2026
Il modulo COM Express di SECO basato su AMD Ryzen Embedded 8000 Series è ora disponibile per il sampling
Leggi
News, 5 novembre 2026
SECO e Peridio in partnership per accelerare robotica e Physical AI dallo sviluppo al deployment su Qualcomm® Dragonwing™
Leggi
Blog
Industrial Edge AI nel 2027: ciò per cui gli OEM devono progettare oggi
Leggi
Ricevi la newsletter di SECO.
Iscriviti con il tuo indirizzo email su seco.com.