
- AI
- Edge Computing
- Industries
- Clea
Edge AI bien hecha: cómo creamos LLM+RAG listo para producción en un módulo SMARC
Implementamos Llama 3.2 3B con un pipeline RAG (Retrieval-Augmented Generation) completo en hardware edge Qualcomm® Dragonwing™ QCS6490, y demostramos que aplicaciones de IA sofisticadas pueden funcionar de forma fiable en entornos de producción sin depender de la nube. Esta es la realidad de ingeniería que hay detrás de que funcione.
El verdadero reto de ingeniería
El entusiasmo por la "IA en el edge" lleva años creciendo, pero la mayoría de las implementaciones se quedan cortas cuando se intenta desplegarlas en entornos de producción reales. Claro que se puede ejecutar un chatbot en una Raspberry Pi, pero ¿qué ocurre cuando se necesita:
- Rendimiento sostenido con cargas de trabajo de IA reales
- Integración con sistemas industriales existentes
- Funcionamiento fiable en entornos exigentes
- Escalado rentable a cientos de unidades
En Embedded World demostramos algo distinto: un sistema de IA de grado de producción que combina el modelo de 3B de Llama 3.2, edge-optimized, con una implementación RAG completa, y que funciona íntegramente en hardware edge sin recurrir a la nube.
Por qué importa esta implementación
La relevancia no está en ejecutar un LLM en hardware edge: los modelos lightweight de Llama 3.2 se diseñaron específicamente para dispositivos edge y aplicaciones móviles. El logro de ingeniería está en crear un sistema de IA completo que funcione de forma fiable en escenarios de producción.
El sistema completo integra el modelo de 3B de Llama 3.2, edge-optimized, con un pipeline RAG completo que gestiona embeddings vectoriales, búsqueda semántica y recuperación de documentos en tiempo real a partir de bases de conocimiento locales. Todo ello funciona junto con el procesamiento simultáneo de consultas y una integración fluida con sistemas HMI industriales, sin degradación del rendimiento.
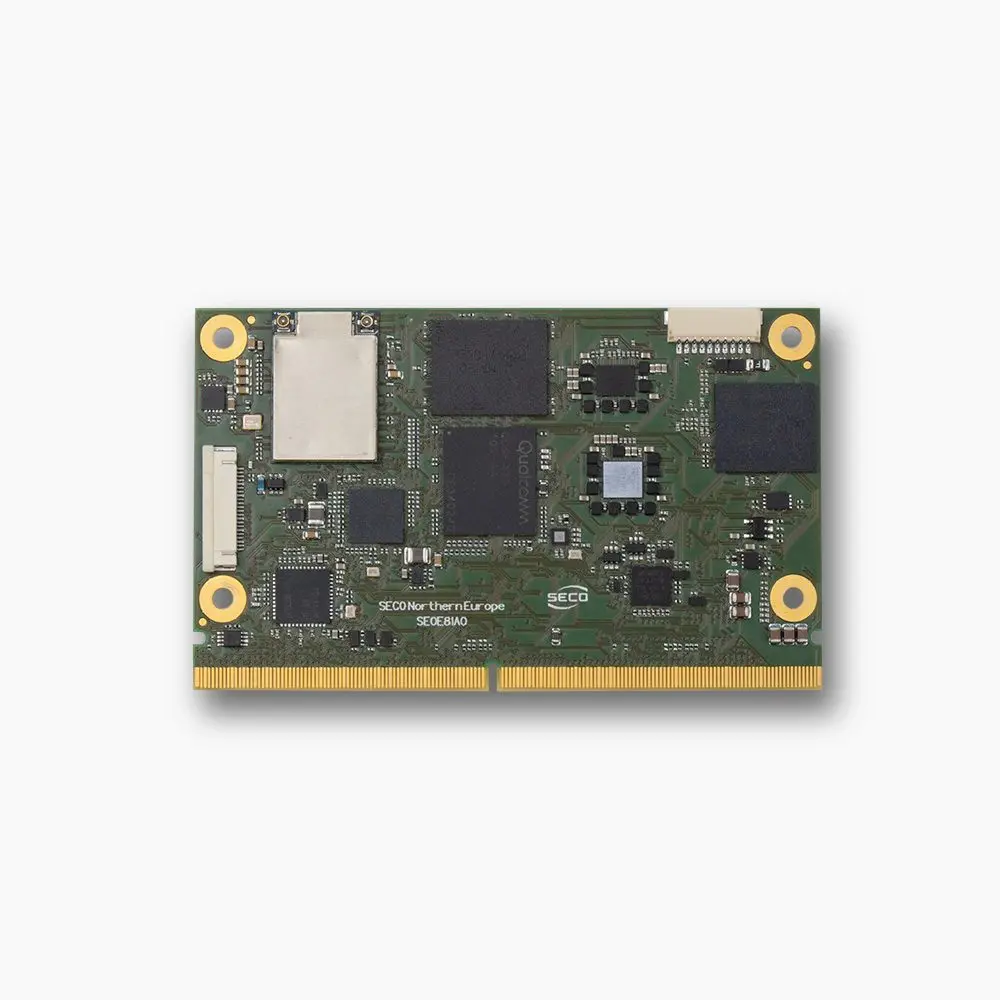
La base de hardware es nuestro módulo SOM-SMARC-QCS6490, construido en torno al procesador Qualcomm® Dragonwing™ QCS6490 con su CPU Qualcomm® Kryo™ 670 de 8 núcleos, el procesador Qualcomm® Dragonwing™ QCS6490 integrado y la NPU Qualcomm® Hexagon™ 770, capaz de alcanzar hasta 12 TOPS. El factor de forma SMARC estándar facilita la integración y mantiene la fiabilidad y la gestión térmica de grado industrial que exigen los entornos de producción.
Análisis técnico en profundidad
Una arquitectura de software que realmente escala
Lo construimos sobre nuestra plataforma Clea OS, un sistema personalizado basado en Yocto, con nuestro framework Clea AI Studio orquestando todo el pipeline de IA. La arquitectura aprovecha el AI Hub de Qualcomm para las optimizaciones específicas de hardware y utiliza su AI Engine Direct SDK para repartir de forma inteligente las cargas de trabajo entre la CPU, la GPU y la NPU. Para el motor de inferencia, implementamos Llama.cpp, con su enfoque eficiente en memoria y su soporte de cuantización integrado, el llamado quantization.
La implementación de RAG exigió una ingeniería cuidadosa para las limitaciones del edge. Desarrollamos una base de datos vectorial local con umbrales de similitud configurables, implementamos un almacenamiento de documentos mapeado en memoria para una recuperación instantánea y creamos una arquitectura de procesamiento paralelo que evita cualquier bloqueo durante las operaciones de recuperación.
El proceso de consulta en dos etapas
Durante la primera etapa, llamada fase de limpieza de datos, el sistema limpia y reformula la entrada del usuario y la optimiza tanto para el modelo de embeddings como para la base de datos de documentos local. No se trata solo de limpiar texto, sino de un preprocesamiento semántico que mejora de forma notable la precisión de la recuperación. En la segunda etapa, se recuperan y clasifican los documentos relevantes y se pasan como contexto al LLM junto con la consulta original. El modelo genera respuestas que, además de apoyarse en hechos de la base de conocimiento local, resultan adecuadas al contexto.
Un rendimiento que importa en producción
Las cifras reales de pruebas sostenidas, y no de escenarios de demostración escogidos a conveniencia, muestran una latencia de respuesta inferior a 2 segundos en consultas técnicas complejas con recuperación de documentos. El sistema mantiene una huella de memoria total de 4GB a plena carga y consume 8-12W durante el procesamiento activo de IA. Varios usuarios pueden trabajar a la vez mientras se indexan documentos en segundo plano, sin degradación del rendimiento, y el sistema mantiene un funcionamiento 24/7 en entornos industriales.
Aplicaciones real-world que hacemos posibles
Esta implementación hace posibles varias aplicaciones industriales prácticas, entre ellas:
Asistente de documentación técnica - Los operarios de los equipos pueden plantear preguntas complejas sobre procedimientos, pasos de resolución de problemas o especificaciones. La IA recupera las secciones relevantes de manuales, esquemas y registros de mantenimiento y ofrece respuestas completas sin necesidad de conectividad.
Inteligencia de mantenimiento predictivo - En lugar de simples alertas por umbral, el sistema correlaciona los datos de los sensores con patrones históricos y con la documentación de mantenimiento. Puede explicar por qué podría estar fallando un componente y sugerir acciones correctivas concretas a partir de bases de conocimiento especializado locales.
Evolución de la HMI industrial - Los operarios pueden transformar las interfaces tradicionales de botones y menús en interacciones en lenguaje natural: consultar el estado del sistema, solicitar informes u obtener orientación sobre procedimientos mediante interfaces conversacionales que entienden el contexto técnico.
La realidad de la integración
El factor de forma SMARC significa que esta solución se incorpora a los diseños existentes sin grandes rediseños de placa. Nuestros clientes la integran en paneles de control industrial, unidades de control de vehículos autónomos, interfaces de dispositivos médicos y sistemas de gestión de edificios inteligentes. El framework Clea se encarga de la complejidad del despliegue de modelos, la gestión de memoria y la integración del sistema, para que usted pueda centrarse en la lógica de su aplicación en lugar de pelearse con la infraestructura de IA.
Qué viene ahora
La implementación del Dragonwing™ QCS6490 demuestra la prueba de concepto, pero no nos detenemos aquí. Nuestro desarrollo del Qualcomm® Dragonwing™ QCS5430 se dirige a despliegues en los que el escalado del rendimiento en campo es crítico, ya que la posibilidad de actualizar el rendimiento de la CPU tras el despliegue abre nuevas posibilidades para productos industriales de ciclo de vida largo. Para aplicaciones que requieren una gran potencia de cálculo, nuestra integración de Snapdragon X ofrecerá 45 TOPS para el análisis de vídeo en tiempo real con procesamiento simultáneo de LLM en sistemas avanzados de videovigilancia o de control de calidad.
Para integradores de sistemas: lo esencial
Los modelos edge de Llama 3.2 se optimizaron mediante técnicas de poda (pruning) y de destilación del conocimiento que reducen el tamaño del modelo sin perder rendimiento, pero hacerlos funcionar de forma fiable en sistemas de producción requiere un esfuerzo de ingeniería considerable, más allá de limitarse a ejecutar el modelo.
Ya hemos hecho ese trabajo de ingeniería. Esto no es una prueba de concepto: es una plataforma lista para producción que elimina la complejidad del despliegue de IA y ofrece el rendimiento y la fiabilidad que exigen las aplicaciones industriales.
El futuro de la IA no está centralizado en los centros de datos de la nube. Es distribuido, privado, y se ejecuta justo donde se necesita para tomar decisiones. Y ya está disponible hoy en un hardware que usted puede desplegar.
¿Le interesan los detalles técnicos de la implementación? Nuestro equipo de ingeniería está documentando las técnicas de optimización, las metodologías de benchmarking y los patrones de integración. Póngase en contacto con nosotros para hablar de sus requisitos específicos de Edge AI.
Destacado en este artículo
SOM-SMARC-QCS6490
Módulo SMARC® 2.1.1 impulsado por el procesador Qualcomm® Dragonwing™ QCS6490.
- SMARC®
- Qualcomm® QCS6490
Seguir leyendo

Noticias, 12 de noviembre de 2026
El módulo COM Express de SECO basado en AMD Ryzen Embedded 8000 Series ya está disponible para solicitar muestras
Leer
Noticias, 5 de noviembre de 2026
SECO y Peridio se asocian para acelerar la robótica y la Physical AI, del desarrollo al despliegue en Qualcomm® Dragonwing™
Leer
Blog
IA industrial en el borde en 2027: lo que los OEM deben tener en cuenta en sus diseños desde hoy
Leer
Reciba la newsletter de SECO.
Suscríbase con su dirección de correo en seco.com.